
O Strata apareceu em quase todo artigo da reta final do benchmark v4. No de open source nível consumidor ele foi o protagonista; no de quanto custa um time em B300 e H200 o modelo que ele serve virou a recomendação pra DGX Spark; e no veredito do v4 ele é a única resposta séria pra quem quer rodar modelo bom em casa.
O resultado, resumido: o Qwen3.8 Flash-Next servido pelo Strata numa RTX 5090 fez 91, Tier A, com zero nudges e os 14 defeitos plantados resolvidos (dois só depois da revelação), a 1,5 ponto do mesmo modelo rodando numa B300 de datacenter. E fez isso a uns 159 tokens por segundo.
Neste artigo eu detalho o que é o Strata, por que ele importa justo agora, o que ele não resolve, e como eu deixei ele rodando no dia a dia, com carga e descarga automática e integrado no OpenCode.
O que é o Strata
O Strata é um motor de inferência open source, licença MIT, feito em torno de um modelo: o Qwen3.8 Flash-Next, um MoE de 125 bilhões de parâmetros com 6 bilhões ativos por token, que normalmente pede servidor. O código é C++ e CUDA, reaproveita partes do llama.cpp/ggml, e tem builds pra NVIDIA, AMD (inclusive Strix Halo), Intel Arc e Mac. Ele sobe uma API compatível com OpenAI e com Anthropic em localhost.
O truque é tratar o PC inteiro como uma hierarquia de memória. O modelo tem 24.576 especialistas, 512 em cada uma das 48 camadas, e cada token usa só 10 por camada, mais um especialista compartilhado:
- a VRAM guarda os especialistas mais usados, como um cache;
- a RAM guarda todos, e quando o token precisa de um que não está na placa, o processador calcula ele ali mesmo, enquanto a placa trabalha nos outros;
- o SSD guarda uma tabela de consulta de uns 29 GB, da qual o modelo lê poucas linhas por token.
Em cima disso, uma cabeça de especulação que vem com o próprio modelo chuta os próximos tokens e o modelo grande confere todos de uma vez. O README promete a mesma resposta 1,6 a 1,8 vez mais rápido.
Na minha 5090, o log mostra como isso fica na prática. Os 32 GB de VRAM seguram de 10 a 11,5 mil especialistas em uns 20 a 22 GiB, quase metade do total, e em geral de 90% a 97% dos especialistas que cada token pede já estão na placa. O resto a CPU calcula direto na RAM, e só uma fração pequena é copiada pra placa pelo barramento PCIe. É por isso que a CPU também trabalha pesado, como dá pra ver mais abaixo.
Por que isso importa agora
Porque memória virou artigo de luxo. Em 2026 o preço de contrato da DRAM quase dobrou num único trimestre, os fabricantes continuam priorizando servidor, e a Micron largou o mercado consumidor pra atender os clientes grandes. A própria RTX 5090, quando aparece, custa de duas vezes e meia a quase cinco vezes o preço sugerido, como eu contei no veredito.
Nesse cenário, a forma tradicional de rodar um modelo Tier A em casa, com o modelo inteiro dentro da VRAM, é inviável. O Flash-Next em NVFP4 ocupou uns 100 GB de placa na B300; em casa ninguém tem isso.
O Strata inverte a premissa: em vez de exigir VRAM pro modelo inteiro, ele usa a VRAM como cache e a RAM como estoque. É o que permite um modelo Tier A rodar com uma fração da memória de vídeo que ele pediria.
Não é mágica
O Strata faz caber, mas não faz milagre. O mínimo declarado é 32 GB somando RAM e VRAM, mas com isso roda só a versão mais comprimida; a IQ3_S que fez os 91 pede uns 64 GB de RAM. Some uns 80 GB de disco, de preferência SSD, e uma placa de 12 GB pra cima no caminho oficial. Abaixo disso até sobe, tem relato com placa de 8 GB, mas a uns 15 tokens por segundo.
Banda de memória é o que define a velocidade
Na geração de token, o gargalo de máquina local quase nunca é o cálculo. É quantos bytes por segundo a memória consegue entregar pros núcleos, porque cada token precisa ler os pesos ativos do modelo. E aí a diferença entre os tipos de memória é brutal:
| Memória | Banda aproximada | Contra a 5090 |
|---|---|---|
| VRAM GDDR7 da RTX 5090 | ~1,8 TB/s | 1x |
| Memória unificada LPDDR5X do Strix Halo | ~256 GB/s | 7 vezes mais lenta |
| RAM DDR5 de desktop, dois canais | ~60 a 100 GB/s | 18 a 30 vezes mais lenta |
| Barramento PCIe 5.0 x16 | ~64 GB/s por sentido | quase 30 vezes mais lento |
| PCIe medido pelo Strata na minha máquina (placa em x8) | ~29 GB/s | uns 60 vezes mais lento |
A última linha é da minha máquina: a placa está rodando com 8 linhas de PCIe em vez de 16, e o Strata mede isso na inicialização. Mais um motivo pra o cache na VRAM ser tão importante.
O Strix Halo tem 128 GB e cabe muito mais coisa que uma 5090, mas cada byte chega sete vezes mais devagar. Foi isso que eu medi no benchmark: o Qwen 3.8 27B denso em Q8 lê uns 29 GB por token, e na Strix o teto teórico fica perto de 9 tokens por segundo. Eu medi 7,7. A mesma conta na banda da 5090 daria uns 60, sete vezes mais, se o modelo coubesse com o contexto.
É por isso que o desenho do Strata funciona: o caminho quente fica na GDDR7, e o que falta no cache é calculado pela CPU na DDR5, ou atravessa o PCIe, os dois dezenas de vezes mais lentos. Com mais de 90% de acerto no cache, o pouco que fica de fora não derruba a velocidade. Numa placa pequena, o cache cobre menos, mais especialistas vão pela estrada lenta, e a velocidade cai: o próprio autor publica 53 tokens por segundo numa RTX 5070 de 12 GB, um terço da minha 5090.
PC batata não roda
Então esqueça notebook com GPU integrada e 16 GB de RAM. Sem uma placa dedicada razoável, sem 32 GB somando RAM e VRAM e sem SSD, o modelo não sobe, ou sobe e anda na velocidade da RAM, que é a de uma carroça.
E tem o custo de entrada que não aparece na velocidade de geração: o Strata lê a primeira mensagem de cada conversa inteira, e o README fala em uns 60 segundos a cada 30 mil tokens como regra geral. Na minha 5090 é bem mais rápido, uns 100 mil tokens em 16 a 20 segundos, mas numa placa menor conte com o número do README. Agente de código manda prompt de sistema grande, então a primeira resposta de cada sessão demora mais que as seguintes.
Pesado até na minha 5090
Minha máquina não é fraca: Ryzen 9 7950X3D, 96 GB de RAM (o sistema enxerga uns 92), RTX 5090 de 32 GB. Mesmo assim, o Flash-Next ocupa tudo:
- na carga, ele joga uns 50 GB de especialistas na RAM, a uns 3 GB por segundo com o SSD frio, e enche o cache da placa com mais de 20 GiB;
- com tudo carregado, sobram menos de 800 MB de VRAM livre;
- com o servidor de pé, a máquina fica com 88 dos 92 GB de RAM ocupados, e o sistema começa a usar swap.
Este é o btop no meio de uma sessão de trabalho com o OpenCode. O processo do Strata sozinho segura 54 GB de RAM e metade da CPU, com metade das 32 threads do 7950X3D cravadas em 100% e o resto acima de 50%. A 5090 está a 99% de uso, com 30 dos 32 GB de VRAM ocupados e puxando 351 W. Sobram 4 GB de RAM disponíveis, e já tem quase 48 GB em swap.
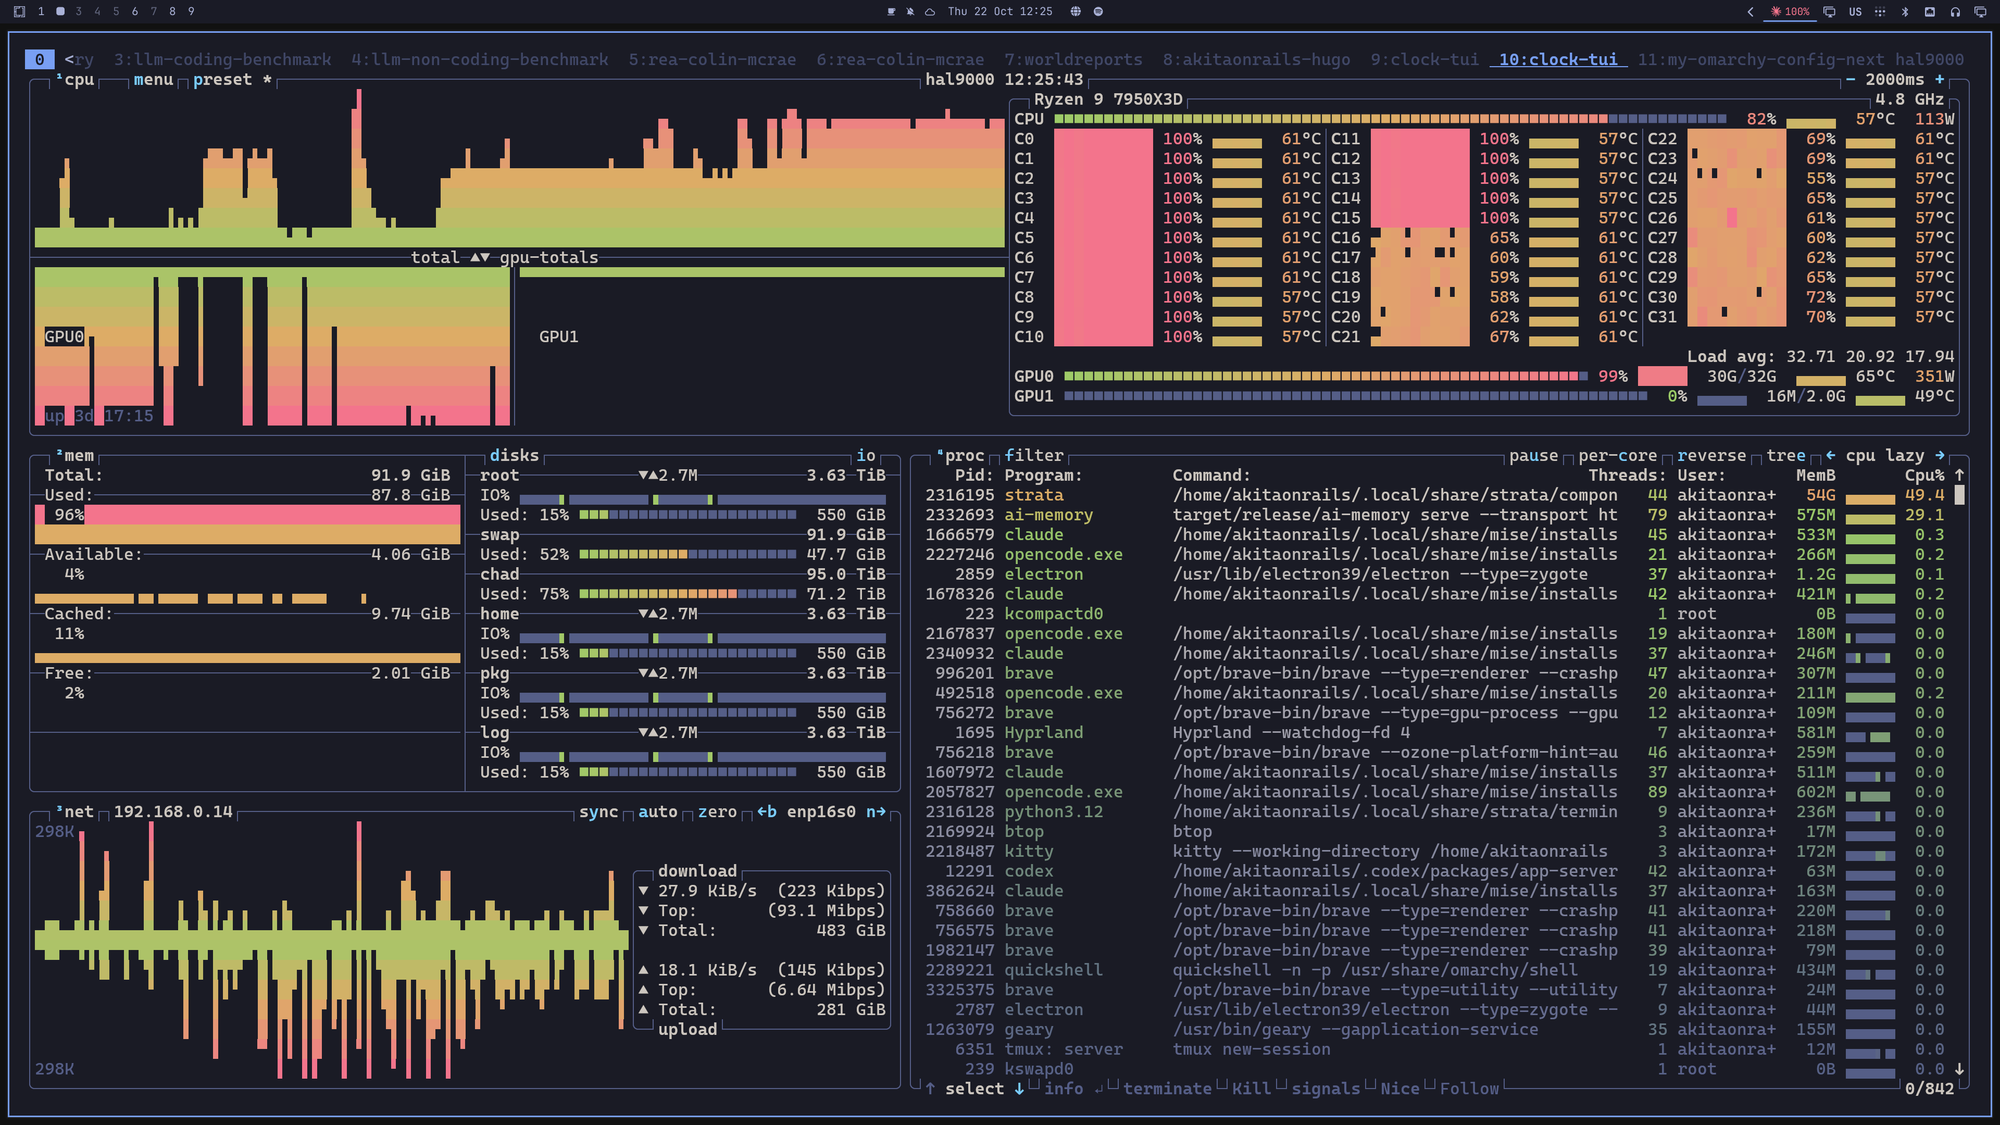
O efeito colateral aparece no resto do sistema. Com a VRAM no limite, o lançador de aplicativos do meu desktop e o terminal num monitor secundário pararam de abrir direito, e outros programas ficam lentos. A solução foi mandar o Strata devolver uns 2,5 GB de VRAM pro desktop, com a opção --vram-elastic, ao custo de um cache um pouco menor.
Com tudo isso, eu acredito firmemente que a minha máquina é o mínimo pra usar um LLM local em trabalho de programação de verdade, além de exercício pequeno. Com menos que isso, conte com velocidade bem menor, contexto mais curto e o PC inteiro sofrendo enquanto o modelo está carregado.
Como instalar
O caminho oficial no Linux e no Mac é o instalador de uma linha. Ele verifica o SHA-256, não pede root e instala na sua pasta pessoal. Como todo curl | sh, vale baixar e ler antes:
curl -fsSL https://github.com/Niko1221/Strata/releases/latest/download/install.sh -o install.sh
less install.sh
sh install.sh
Depois, o strata launch pergunta modelo, contexto e acesso, baixa o motor certo pra sua placa e o modelo, e começa a servir. Pra scripts, tudo vai por flag:
strata launch                                # telas guiadas
strata launch --model <variante> --yes --no-tui   # sem perguntas
strata launch --status                       # o que está servindo
strata launch --stop                         # parar
strata monitor --url http://127.0.0.1:8080   # velocidade, GPU, memória
Eu usei a variante IQ3_S, a que fez os 91 no benchmark. No disco ela ocupa uns 84 GB em dois arquivos (o modelo de 55 GB e a tabela de consulta de 29 GB), mais uns 7 GB da cabeça de especulação.
A configuração que o strata launch gera é um JSON com os argumentos do motor. Os que importam na minha:
"args": [
  "--expert-cache", "auto",
  "--prefill", "auto",
  "--spec", "4", "--spec-min-p", "0.5",
  "--mtp", "/mnt/data/strata-models/mtp/rt",
  "--max-context", "262144",
  "--kv", "int8",
  "--kv-resident", "32768",
  "--vram-elastic"
]
O --spec 4 liga a especulação com uma janela de 4 tokens por passo, até 3 chutados pela cabeça de especulação; o --kv int8 guarda o cache de atenção em 8 bits; o --kv-resident deixa só 32 mil posições do cache de contexto, as mais lidas, na VRAM; e o --vram-elastic permite devolver VRAM pro desktop com o servidor rodando.
De 128 mil pra 256 mil tokens de contexto
O benchmark rodou com 128 mil tokens de contexto, que é o que a instalação configurou por padrão. Depois eu subi pra 256 mil, com --max-context 262144, e a perda foi pequena: nos logs do servidor, a geração ficou na média de uns 190 tokens por segundo numa sessão curta com 128 mil e de uns 175 com 256 mil, uns 10% mais lenta pelo dobro de contexto, um pouco mais com a VRAM devolvida pro desktop.
O que segura isso é o --kv-resident: só 32 mil posições do cache de atenção, as mais lidas, ficam na VRAM, o resto fica na RAM, e mesmo assim umas 97% das leituras desse cache acontecem na placa. A nota de 91 do benchmark foi medida com 128 mil; com 256 mil eu medi velocidade, e a qualidade ainda não foi re-testada.
Pra mim, 256 mil é o mínimo pra trabalho longo com agente. Com 128 mil, uma sessão de verdade estoura o contexto rápido, e o agente começa a compactar a memória toda hora. Isso fica irritante muito rápido, e cada compactação joga fora detalhe que o modelo vai precisar mais tarde.
Contexto curto é um problema escondido de modelo local. Antes de olhar tokens por segundo, veja quanto contexto você consegue servir sem a velocidade desabar.
Carregar e descarregar sozinho
Deixar uns 50 GB de RAM e a placa inteira presos o dia todo, só pra ter o modelo pronto quando eu precisar, não faz sentido. Então montei um proxy pequeno, em Python puro, que fica sempre de pé na porta 8080 e controla o Strata:
- responde a lista de modelos sozinho, então o OpenCode enxerga o modelo sem acordar nada;
- na primeira requisição de chat, sobe o Strata numa porta interna e espera ficar pronto, uns 40 segundos;
- repassa as respostas em streaming;
- depois de 10 minutos sem tráfego, derruba o Strata e devolve a placa e a RAM pro sistema; nunca no meio de uma requisição.
O miolo é este:
def ensure_up():
    with _lock:
        if ready():
            return True
        subprocess.Popen([STRATA, "serve", "--config", CFG,
                          "--host", "127.0.0.1", "--port", str(UP_PORT)],
                         start_new_session=True)
        for _ in range(90):          # carga a frio leva ~35-40 s
            if ready():
                set_reserve()        # devolve VRAM pro desktop
                return True
            time.sleep(2)
        return False

def idle_watch():
    while True:
        time.sleep(30)
        if time.time() - _last > IDLE_TTL:
            # nunca derrube o motor com requisição em voo (ver abaixo),
            # mas com teto: requisição vazando não prende a GPU pra sempre
            if _active > 0 and (time.time() - _last) < ACTIVE_HARD_CAP_S:
                continue
            stop_up()                # libera GPU e ~50 GB de RAM
E um serviço de usuário do systemd mantém o proxy de pé desde o login (versão resumida):
# ~/.config/systemd/user/qwen-strata.service
[Unit]
Description=Qwen3.8 Flash-Next on-demand proxy (Strata RTX 5090)
After=network-online.target

[Service]
Environment=QWEN_IDLE_TTL=600
Environment=QWEN_VRAM_RESERVE_MIB=2560
Environment=QWEN_UP_PORT=8781
Environment=QWEN_PROXY_PORT=8080
ExecStart=%h/.local/bin/qwen-strata-ondemand
Restart=on-failure
KillMode=mixed

[Install]
WantedBy=default.target
systemctl --user daemon-reload
systemctl --user enable --now qwen-strata.serviceO bug do “parou do nada”
A primeira versão desse vigilante de idle tinha um bug maldoso, e vale contar porque ele ensina uma coisa sobre modelos que pensam sempre. O Flash-Next raciocina antes de responder, e numa fase longa de raciocínio ele pode ficar mais de 10 minutos sem emitir um único byte. Para o relógio de idle, aquilo era “ninguém usando”: o proxy derrubava o Strata no meio da própria requisição, engolia a truncagem do stream, e o OpenCode recebia um turno vazio, sem conteúdo e sem erro. O modelo parecia ter parado do nada.
Três correções, todas no proxy:
- Contador de requisições em voo (
_active, oifnovo do trecho acima): enquanto houver uma requisição em andamento, o motor não cai. Com teto: depois deQWEN_ACTIVE_HARD_CAP_S(1 hora por padrão, seis vezes o TTL normal), até uma requisição vazando por bug não consegue prender a GPU e a RAM pra sempre. - Relógio atualizado por byte: o contador de idle agora zera no início de cada requisição e a cada pedaço repassado no streaming. Geração em curso nunca conta como inatividade; o período sem byte nenhum, que é o raciocínio puro, fica coberto pelo
_active. - Falha honesta no meio do stream: se o motor morrer mesmo assim, o proxy agora emite um evento de erro no stream (
"upstream engine died mid-stream") em vez de fechar calado. O agente vê que a resposta morreu e tenta de novo, em vez de ficar olhando um turno vazio parecendo travado.
O preço é a espera na primeira mensagem depois de um tempo parado. Em troca, quando eu não estou programando, a máquina volta a ser minha.
Configurando o OpenCode
O Strata tem um atalho, strata connect opencode --write, que escreve a configuração depois de perguntar e guarda backup. Na mão, é um provider compatível com OpenAI apontando pra porta local:
"provider": {
  "strata-5090": {
    "npm": "@ai-sdk/openai-compatible",
    "name": "Strata (RTX 5090)",
    "options": {
      "baseURL": "http://127.0.0.1:8080/v1",
      "apiKey": "local"
    },
    "models": {
      "qwen3.8-flash-next-iq3_s": {
        "name": "Qwen3.8 Flash-Next IQ3_S (Strata 5090)",
        "reasoning": true,
        "tool_call": true,
        "limit": { "context": 262144, "input": 229376, "output": 32768 }
      }
    }
  }
}
Qualquer chave serve, porque o servidor é local. O próprio Strata avisa que o OpenCode precisa do limit.input, pra saber quanto do contexto sobra pra entrada; no exemplo eu pus o contexto menos a saída máxima. O Claude Code também funciona, apontando ANTHROPIC_BASE_URL pra http://127.0.0.1:8080 e ajustando CLAUDE_CODE_MAX_CONTEXT_TOKENS pro tamanho do contexto, já que o Strata fala a API da Anthropic também.
Um detalhe: por padrão o Strata atende uma requisição por vez. Se o seu agente dispara subagentes em paralelo, eles entram em fila.
E no dia a dia?
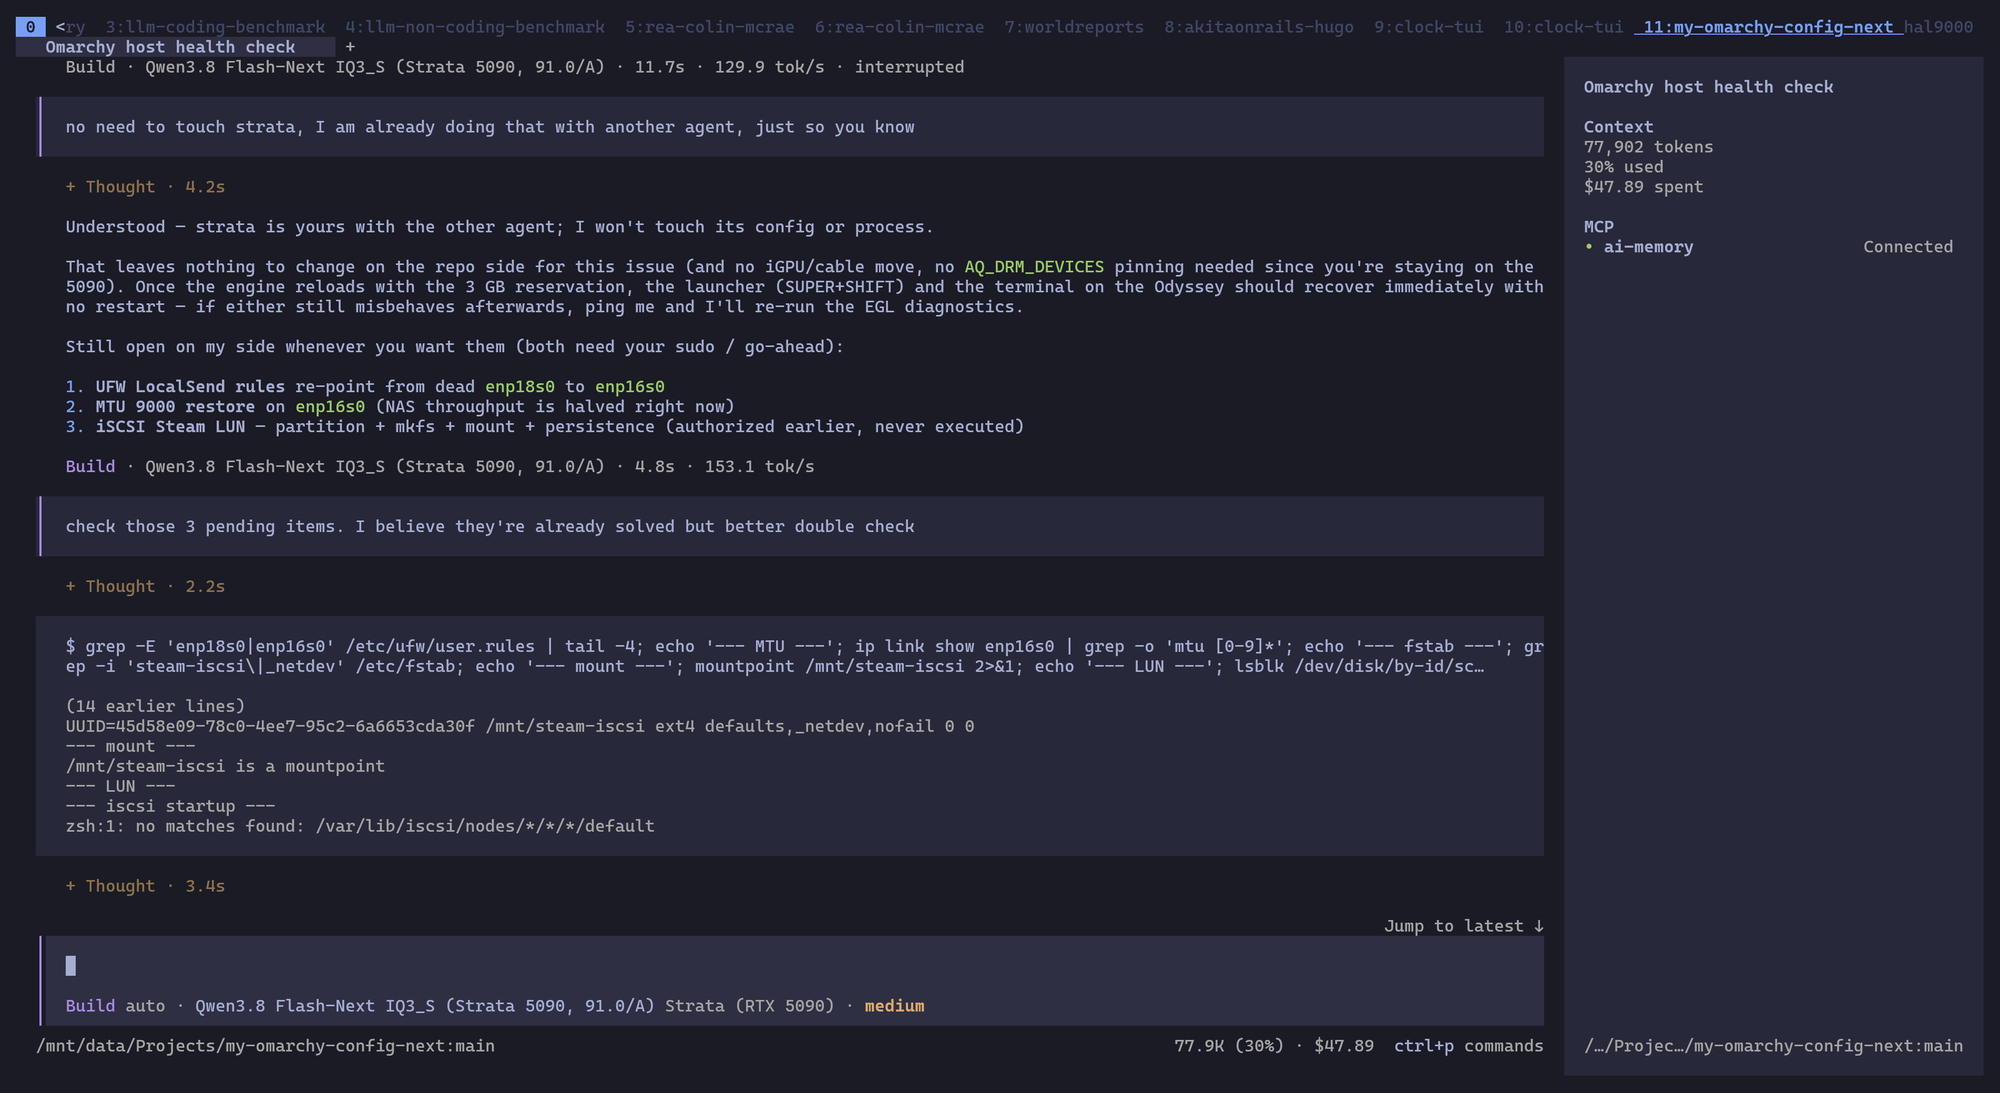
Se você tem a máquina pra isso, o resultado é bom. O Flash-Next passa de 150 tokens por segundo na maior parte do tempo, como dá pra ver no print do começo, e a chamada de ferramenta é sólida: no benchmark ele rodou as sete sprints no OpenCode sem nenhum empurrão, e no uso normal ele lê arquivo, roda comando e edita código sem tropeçar no formato.
Na prática, não sinto muita diferença pro Claude Code ou pro OpenCode com GLM ou Kimi na nuvem. E a nuvem não anda no melhor momento: na minha percepção, todos esses serviços estão um pouco mais lentos que o normal ultimamente, provavelmente sofrendo com demanda maior que a capacidade disponível. Rodando em casa, a velocidade é sempre a mesma, e o código não sai da minha máquina.
Mesmo com os tokens por segundo bons, eu ainda sinto o Flash-Next um pouco menos responsivo que um modelo comercial. Tem os segundos de leitura na primeira mensagem de cada sessão, a pausa quando ele precisa de especialistas que não estão na placa, e a carga a frio depois de um tempo parado. É o esperado: estamos rodando um modelo de servidor com os recursos no limite.
Considerando que é de graça e roda na minha máquina, ele está quase bom o suficiente. Pela primeira vez, rodar um modelo local pra programar parece um cenário usável de verdade, e eu me vejo usando cada vez mais como substituto.
O porém continua sendo o hardware. Uma 5090, 96 GB de RAM e um processador forte são o mínimo pra esse cenário, e esse hardware está cada vez mais caro e difícil de achar. Mas, pra quem já tem, o Tier A em casa deixou de ser promessa.